
運営責任者:宇井和朗(株式会社アシスト 代表取締役) プロフィール
💡 結論(要点まとめ)
Google検索の「site:」コマンド(site that/site:演算子)の使い方を詳しく解説。特定ドメインのインデックス登録確認手順、ディレクトリ絞り込み、表示されない原因と対処法をGoogle公式ガイドラインに基づきわかりやすくま
この記事でわかること
- site:コマンドでコロンの後ろにスペースを入れてもよいですか?
- site:検索の表示件数はGoogleの正確なインデックス数ですか?
- site:で特定のページが出ない場合、インデックスされていないと断定できますか?
site:は表示URLの簡易確認用です。URL単位はURL検査、サイト全体はインデックス登録レポートで調べます。
- 分かること:指定したドメインやURL配下で、Google検索に表示されるページを探せる
- 分からないこと:インデックス済みURLの総数、除外理由、Googleが選んだ正規URLは判定できない
- 次の確認先:特定URLはURL検査、全体傾向は「ページのインデックス登録」レポートで確認する
「site that」と検索した方へ:Google検索でドメインを絞る機能は、半角コロンを付けた「site:」演算子です。指定したドメイン、URL、URLプレフィックスに検索結果を絞り込み、自サイトのページが検索結果に現れるかを簡易確認できます。
Google検索セントラルによると、site:の結果は網羅的ではありません。公開した記事が出ない場合も、site:だけで未登録やペナルティとは判断せず、Search Consoleへ調査を移します。(出典: Google検索セントラル「site: 検索演算子」、2026年9月確認)
- 1ページだけ出ない:URL検査の使い方に沿って登録状態、クロール、canonicalを確認
- 新規ページが広く出ない:内部リンクとXMLサイトマップの作り方を確認
- 多数のURLに異変がある:「ページのインデックス登録」レポートと大規模サイト向けクロール監査で傾向を確認
目次
「site that」とは?Googleのsite:検索演算子の意味
site:は、指定したドメイン、URL、URLプレフィックスに検索結果を絞り込む検索演算子です。
site:演算子でできること
- 指定ドメインに関連する検索結果を探す
- ディレクトリやサブドメインを指定して対象を狭める
- キーワードを加えて、サイト内の関連ページを探す
- 公開中のタイトルやスニペットを目視する
- 検索結果で気になったURLを、Search Consoleの診断対象として控える
Google検索セントラルによると、site:にはドメインのほか、URLやURLプレフィックスを指定できます。ただし、該当範囲のURLがすべて表示されるわけではなく、結果件数もインデックス総数としては使えません。(出典: Google検索セントラル「site: 検索演算子」、2026年9月確認)
英語表現の「site that」と検索コマンドの違い
英語の「site that …」は「〜するサイト」といった一般的な英文です。Google検索の絞り込みに使う場合は、半角コロンを付けたsite:と入力します。
site:検索で分かること・分からないこと
| 観点 | site:検索 | Google Search Console |
|---|---|---|
| 主な用途 | 検索結果に現れるURLの簡易確認 | 所有確認済みサイトの診断 |
| URL単位の状態 | 登録状態や除外理由は分からない | URL検査で確認する |
| サイト全体の傾向 | 網羅的な集計には使えない | インデックス登録レポートで確認する |
| 正規URL | 判定できない | URL検査で指定URLとGoogle選択URLを比較する |
| 次の行動 | 気になったURLと検索条件を控える | 原因に応じて設定やサイト構造を見直す |
site:コマンドの正しい使い方と入力手順
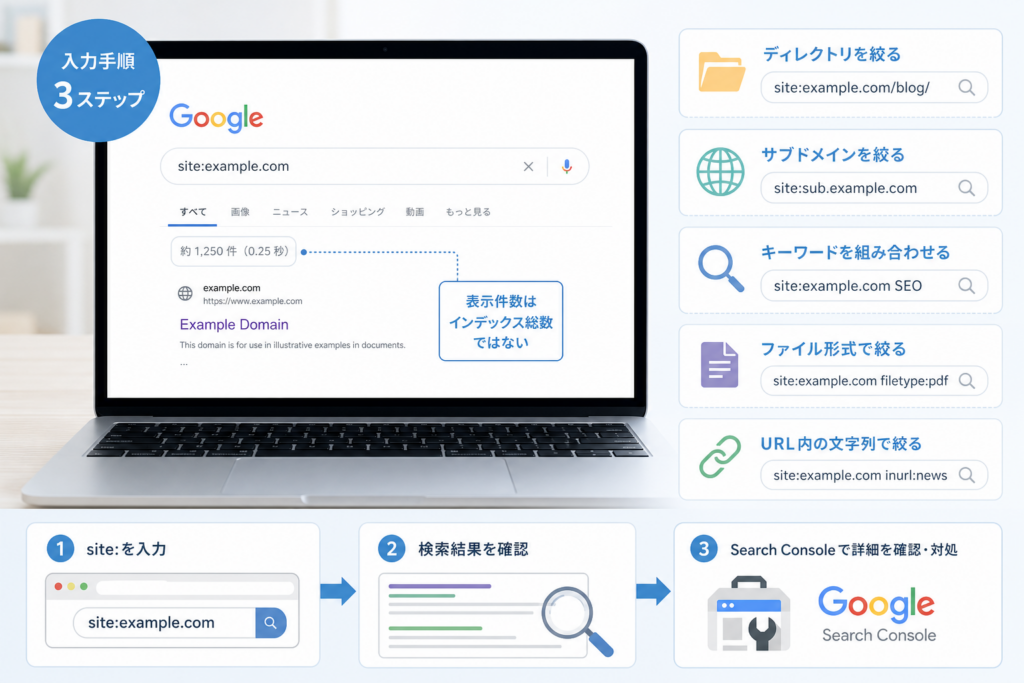
Googleの検索ボックスにsite:example.comと入力します。コロンの直後にはスペースを入れません。
ドメイン全体・特定URLを調べる書き方
| 目的 | 入力例 | 確認時の注意 |
|---|---|---|
| ドメインを指定 | site:example.com |
結果は全URLの一覧ではない |
| ディレクトリを指定 | site:example.com/blog/ |
配下URLが網羅されるわけではない |
| 特定URLを指定 | site:https://example.com/page/ |
登録状態はURL検査へ移って確認する |
| キーワードを追加 | site:example.com 送料 |
ドメイン指定と語句の間を空ける |
PC・スマートフォンでの手順
- Google検索を開く
- 検索ボックスへ
site:と調べたいドメインまたはURLを入力する - 半角コロンで、直後に空白がないことを確認する
- 表示されたURL、タイトル、スニペットを確認する
- 診断が必要なURLをSearch ConsoleのURL検査へ入力する
Google検索セントラルの検索演算子ガイドでは、演算子によって検索結果を絞り込める一方、インデックスや取得に関する制限があると案内されています。検索演算子は調査の入口として扱います。(出典: Google検索セントラル「Google検索演算子の概要」、2026年9月確認)
Search Consoleをまだ設定していない場合は、先にGoogle Search Consoleの導入手順でプロパティと所有権確認を済ませると、site:で見つけた異変をURL単位で追えます。
ディレクトリ・サブドメイン・キーワードで範囲を絞る方法
パスやサブドメインを含めると確認対象を狭められます。ただし、指定範囲の全URLを抽出する機能ではありません。
- ディレクトリ限定:
site:example.com/news/ - サブドメイン限定:
site:shop.example.com - 特定範囲を除外:
site:example.com -site:example.com/blog/ - 語句を追加:
site:example.com 採用情報
Google検索セントラルによると、site:はURLプレフィックスにも対応しますが、指定範囲に属する全URLの表示は保証されません。ディレクトリ単位の件数比較も概算として扱います。(出典: Google検索セントラル「site: 検索演算子」、2026年9月確認)
Search Consoleのプロパティとsite:の指定範囲は別概念
| 項目 | 対象範囲 | 使い分け |
|---|---|---|
| ドメインプロパティ | 所有確認したドメイン配下のプロトコル、サブドメイン、パス | ドメイン全体を横断して管理する |
| URLプレフィックスプロパティ | 登録したプロトコル、ホスト名、パスに一致する範囲 | 特定のURL範囲を分けて管理する |
| site:の指定 | 検索時に入力したドメインまたはURLプレフィックス | 検索結果を簡易的に絞り込む |
Google Search Consoleヘルプによると、ドメインプロパティには、指定ドメイン配下のすべてのサブドメインと複数のプロトコルが含まれます。URLプレフィックスプロパティとは対象範囲と確認方法が異なります。(出典: Google Search Consoleヘルプ「ウェブサイト プロパティを Search Console に追加する」、2026年9月確認)

filetype:・inurl:・intitle:を使う補助的なSEO点検
公式に案内されている検索演算子と、補助的に使われる検索テクニックは分けて扱います。いずれも結果は網羅的ではありません。
| 探したいもの | 構文例 | 点検の観点 | 限界 |
|---|---|---|---|
| 公開中のPDF | site:example.com filetype:pdf |
自社管理ドメインで旧版や公開予定外の資料が見えていないか | 検索結果に出ないファイルもあるため網羅的ではない |
| 特定文字列を含むURL | site:example.com inurl:utm_source |
指定文字列をURLに含むページを探す | 非公式な補助検索として扱い、挙動や提供が変わる可能性がある |
| ページ番号を含むURL | site:example.com inurl:page= |
ページネーションや絞り込みURLを探す | 結果は網羅的ではない |
| 検証用文字列を含むURL | site:example.com inurl:test |
公開予定でないURLが検索結果に現れていないか探す | 結果は網羅的ではなく、演算子の挙動は変更される場合がある |
| タイトルに指定語を含むページ | site:example.com intitle:料金 |
タイトルに「料金」を含むページを探す | 重複タイトルの判定には使わず、結果も網羅的ではない |
Google検索セントラルは、site:とfiletype:を含む検索演算子をモニタリングやデバッグに利用できると案内しています。一方、検索演算子の結果はインデックスの網羅的な取得手段ではありません。(出典: Google検索セントラル「Google検索演算子の概要」、2026年9月確認)
重複タイトルは検索結果ではなく管理データで調べる
- Search Consoleで検索パフォーマンスや対象URLを確認する
- 管理権限のあるクロールツールでHTMLタイトルを取得する
- CMSの出力データや記事一覧をエクスポートして照合する
- テンプレート由来の接尾辞やカテゴリ名も含めて比較する
大量URLのタイトル、canonical、noindex、ステータスコードを調べる場合、site:よりも管理権限のあるクロールデータが適しています。無料で確認しやすいのはSearch Console、CMS出力、XMLサイトマップです。URLを横断した一覧化や定期監査が必要になった段階で、SEOクロールツール比較を検討してください。
site:検索の件数はインデックス総数ではない
検索結果に表示される件数は概算であり、インデックス済みURLの総数や完全な一覧を示しません。
Google検索セントラルによると、site:では指定したプレフィックスに含まれるすべてのURLが表示されるとは限りません。検索結果の件数を、登録URL総数としてレポートやKPIへ転記する使い方は避けます。(出典: Google検索セントラル「site: 検索演算子」、2026年9月確認)
- 結果件数は検索条件や処理状況により変わる場合がある
- 並び順はサイト内ページの品質順位を表すものではない
- 件数の増減だけでは、インデックス削除や手動による対策を判定できない
- URL単位の状態はSearch ConsoleのURL検査で確認する
- 全体傾向は「ページのインデックス登録」レポートで確認する
| 知りたいこと | 最初に見る場所 | site:の役割 |
|---|---|---|
| 特定記事が登録されているか | URL検査 | 検索結果に現れるかの補助確認 |
| 除外URLの傾向 | ページのインデックス登録レポート | 傾向の集計には使わない |
| Googleが選んだ正規URL | URL検査 | 判定できない |
| 大量URLのタイトルや応答 | CMS出力、サイトマップ、クロールツール | 気になる例を探す入口 |
site:検索でページが出てこない原因の切り分け
「入力→発見→クロール→インデックス→正規化→ポリシー」の順で確認すると、無関係な設定変更を避けやすくなります。
| 段階 | 最初に見る場所 | 手掛かり | 次の対応 |
|---|---|---|---|
| 入力 | Google検索ボックス | 全角コロン、空白、ドメインやパスの誤記 | 半角のsite:で再検索する |
| 発見 | 内部リンク、XMLサイトマップ | リンクやサイトマップに新規URLがない | 関連ページからリンクし、サイトマップを更新する |
| クロール | URL検査、robots.txt、サーバーログ | クロール制限、認証、サーバー応答 | 意図した制御か確認して対象だけ修正する |
| インデックス | URL検査、HTML、HTTPヘッダー | noindexまたはX-Robots-Tag | 掲載が必要なら制御を見直す |
| 正規化 | URL検査、canonical、リダイレクト | 別URLが正規URLとして指定または選択されている | 内部リンク、canonical、サイトマップを整合させる |
| ポリシー | Search Console | 手動による対策、セキュリティの問題 | 通知内容と公式手順に沿って対応する |
原因別の作業は、URL検査、XMLサイトマップ、canonical設定、noindexの確認方法から進められます。
robots.txt・noindex・削除ツールの役割を分ける
Google検索セントラルによると、robots.txtは主にクローラーによるアクセスを管理する仕組みです。noindexをGoogleに認識させるにはクロール可能である必要があり、robots.txtでブロックするとページ内やHTTPヘッダーのnoindexを読み取れない場合があります。(出典: Google検索セントラル「robots.txt の概要」、「noindex を使用して検索インデックス登録をブロックする」、2026年9月確認)
Google Search Consoleヘルプによると、削除ツールの一時的な削除は、Google検索結果での表示を一時的にブロックするための機能です。恒久的に削除する場合は、元ページの削除、適切なHTTP応答、noindex、パスワード保護など、目的に合った対応が別途必要です。(出典: Google Search Consoleヘルプ「削除ツールとセーフサーチ レポート ツール」、2026年9月確認)
Google Search Consoleでインデックス状態を確認する手順
URL検査の初期結果とライブテストは役割が異なります。保存済み情報を確認した後、必要な場合だけ公開中URLをテストします。
- Search Consoleで調査対象を含むプロパティを開く
- 画面上部のURL検査欄へ完全なURLを貼り付ける
- インデックス登録の状態と表示理由を確認する
- クロール日時、参照元、サイトマップの情報を確認する
- 「ユーザーが指定した正規URL」と「Googleが選択した正規URL」を比較する
- 公開中ページの取得可否を確かめる必要があればライブURLをテストする
- 全体傾向を「ページのインデックス登録」レポートで確認する
- 原因を修正した後、必要に応じてインデックス登録をリクエストする
Google Search Consoleヘルプによると、URL検査で最初に表示される情報は、Googleインデックスに保存されているURLの情報です。ライブテストは公開中ページをリアルタイムで調べますが、インデックス登録の可否を保証するものではありません。(出典: Google Search Consoleヘルプ「URL検査ツール」、2026年9月確認)
Google Search Consoleヘルプの「ページのインデックス登録レポート」は、Googleがサイト内で認識しているページのインデックス登録状況を確認するレポートです。レポートのデータはリアルタイムではなく、修正直後の状態と一致しない場合があります。(出典: Google Search Consoleヘルプ「ページのインデックス登録レポート」、2026年9月確認)
URL検査で確認する項目
| 確認項目 | 見る理由 | 次の対応 |
|---|---|---|
| インデックス登録状態 | 登録済みか、登録されていない理由を把握する | 表示された理由に対応する |
| 参照元ページ・サイトマップ | URLの発見経路を確認する | 内部リンクやXMLサイトマップを見直す |
| クロール情報 | 取得状況やクロール可否を見る | robots.txt、認証、サーバー応答を確認する |
| 正規URL | 代表として扱われるURLを確認する | canonical、内部リンク、サイトマップを整合させる |
| ライブテスト | 公開中URLへアクセスできるか確認する | 保存済みの初期結果と混同しない |
site:検索を使うSEO点検チェックリスト
site:は異変に気づく入口として使い、判断はSearch Console、CMS、サイトマップ、ログ、クロールデータで行います。
- □ トップ、サービス、商品、問い合わせなど主要ページを検索する
- □
filetype:pdfで自社管理ドメインの公開ファイルを補助確認する - □ 実際に使用しているパラメータ名をinurl:で探す
- □ intitle:は指定語をタイトルに含むページ探しに限って使う
- □ タイトル重複はCMSデータまたは管理権限のあるクロールツールで確認する
- □ 気になったURLをSearch ConsoleのURL検査へ移す
- □ canonical、noindex、robots.txtの目的が競合していないか確認する
- □ 検索条件、確認日、対象URL、Search Consoleの結果を記録する
Google検索セントラルのSEOスターターガイドでは、利用者と検索エンジンがページを理解し、たどりやすくなるよう、論理的なサイト構造と関連ページへのリンクを用意する考え方が示されています。発見されにくいURLでは、site:の結果だけでなく内部リンクも確認します。(出典: Google検索セントラル「SEOスターターガイド」、2026年9月確認)
原因を切り分けた後に選ぶ診断手段
| 分かったこと | 次に使う手段 | 費用の考え方 |
|---|---|---|
| 特定URLだけ出てこない | URL検査 | Search Consoleで確認できる |
| 新規ページが発見されにくい | 内部リンクとXMLサイトマップ | CMSやSearch Consoleで確認できる範囲が多い |
| 正規URLが意図と違う | canonicalの設定確認 | HTMLとURL検査で確認できる |
| noindexの混在が疑われる | noindex確認手順 | 個別URLはブラウザやURL検査で確認できる |
| 大量URLを一覧化したい | クロールツール比較 | 小規模な確認は無料枠やCMS出力、大規模・定期監査は有料機能も比較する |
| Googlebotのアクセスを調べたい | サーバーログ解析 | ログ提供条件はサーバーや契約により異なる |
site:コマンドに関するよくある質問
コロンの後ろにスペースを入れてもよい?
site:example.comのように、コロンの直後を空けずに入力します。全角ではなく半角のコロンを使います。
表示件数は正確なインデックス数?
正確な総数ではありません。Google検索セントラルによると、site:検索は指定範囲の全URLを網羅するものではありません。(出典: Google検索セントラル「site: 検索演算子」、2026年9月確認)
site:で出てこないと未登録ですか?
site:の結果だけでは判定できません。所有サイトなら、Search ConsoleのURL検査でインデックス登録状態、クロール、noindex、正規URLを確認してください。
特定ディレクトリだけ検索できますか?
site:example.com/blog/のようにパスまで指定できます。ただし、配下URLの全件が表示されるわけではありません。
PDFだけを探す方法は?
site:example.com filetype:pdfで補助的に絞り込めます。網羅的な洗い出しには、ファイル管理画面、XMLサイトマップ、CMS出力、管理権限のあるクロールデータも使います。
inurl:やintitle:の結果は網羅的ですか?
網羅的ではありません。inurl:やintitle:は補助的な検索テクニックとして扱い、挙動や提供が変更される場合があります。重複タイトルはCMS出力や管理権限のあるクロールツールで判定してください。
新しいページはどのくらいで出ますか?
一律の反映時間は公表されていません。内部リンク、XMLサイトマップ、クロール可否、noindex、canonicalを確認し、必要な場合にインデックス登録をリクエストします。
robots.txtでブロックすれば検索結果から削除できますか?
robots.txtは主にクロールを管理する仕組みで、検索結果からの恒久的な削除やアクセス制限を目的とした設定ではありません。robots.txt、noindex、削除ツールの役割を分けてください。
FAQPage構造化データを付けるとFAQが検索結果に出ますか?
表示は保証されません。Google検索セントラルによると、FAQリッチリザルトの表示対象は、信頼できる政府関連サイトや医療関連サイトに限定されています。一般的なサイトでマークアップを実装しても、FAQ形式の検索表示資格を得られるとは限りません。(出典: Google検索セントラル「FAQ構造化データ」、2026年9月確認)
まとめ:site:は入口、診断はSearch Console
- site:はドメイン、URL、URLプレフィックスで検索結果を絞り込む演算子
- 表示件数は概算で、インデックス総数や全URL一覧ではない
- 特定URLの状態はURL検査、全体傾向はインデックス登録レポートで確認する
- inurl:とintitle:は非網羅的な補助検索として扱う
- 重複タイトルはCMS出力や管理権限のあるクロールツールで判定する
- ページが出ない場合は、発見、クロール、noindex、canonical、ポリシーの順に確認する
- 削除ツールによる一時非表示と、元ページの恒久的な削除・アクセス制御を分ける
Google検索セントラルによると、site:はサイトのモニタリングやデバッグを補助しますが、URLの網羅的な確認には適していません。検索結果で異変を見つけたら、Search Console、CMS、XMLサイトマップ、必要に応じてログやクロールデータへ調査を移します。(出典: Google検索セントラル「site: 検索演算子」、2026年9月確認)
📚 参考・出典(編集部が確認した一次ソース)
- Google検索セントラル「site: 検索演算子」
- Google検索セントラル「Google検索演算子の概要」
- Google検索セントラル「SEOスターターガイド」
- Google Search Consoleヘルプ「URL検査ツール」
- Google Search Consoleヘルプ「ページのインデックス登録レポート」
- Google Search Consoleヘルプ「削除ツールとセーフサーチ レポート ツール」
- Google Search Consoleヘルプ「ウェブサイト プロパティを Search Console に追加する」
- Google検索セントラル「robots.txt の概要」
- Google検索セントラル「noindex を使用して検索インデックス登録をブロックする」
- Google検索セントラル「重複したURLを正規化する方法」
- Google検索セントラル「サイトマップについて」
- Google検索セントラル「FAQ構造化データ」
※本記事はGoogleの公開情報を基に編集し、2026年9月18日に内容を確認しています。検索仕様やSearch Consoleの画面名称は変更される場合があるため、作業前にリンク先の公式情報も確認してください。
🧰 お困りごとの解決に
最近更新した記事
 日立白くまくんのランプ点滅|記録方法と修理相談前の確認事項💡 結論(要点まとめ)日立エアコン「白くまくん」のランプが点滅して動かない時の確認ポイントを整理。タイマ…
 Outlookで会議室を予約する手順と空き状況の確認方法💡 結論(要点まとめ)Outlookで会議室を予約する基本手順と空き状況の確認方法を解説。スケジュールア…
 日本郵便の不在票からLINEで再配達を申し込む手順と番号の確認💡 結論(要点まとめ)日本郵便の不在票からLINEで再配達を依頼する手順を整理。公式アカウント「ぽすくま…
 黄金湯 新宿店に行ってきた感想|日曜16時の混雑・待ち時間、108度サウナと水風呂、サウナ予約の方法(2026年10月)この記事の要点当サイトの運営責任者が2026年10月11日(日)16時に黄金湯 新宿店へ。サウナは「45分待ち」と案内さ…
 麺処 花田 池袋店に行ってきた|辛つけ麺(辛さ2倍)の感想・食券を先に買う並び方・営業時間この記事の要点麺処 花田 池袋店は先に店内の券売機で食券を買ってから並ぶ仕組みです。並び始める前に食券を買ってください。…
Google 検索でハウスケアラボの記事を見つけやすくするには、Google の「優先ソース」にハウスケアラボを追加できます(Google のページが開きます)。