運営責任者:宇井和朗(株式会社アシスト 代表取締役) プロフィール
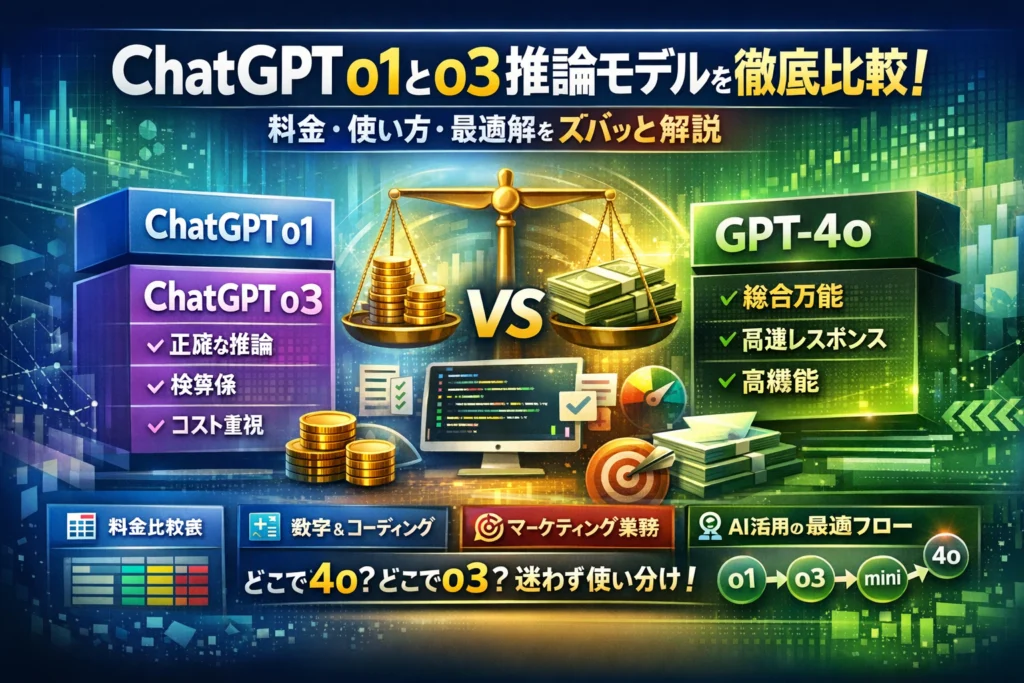
あなたの現場では、ChatGPTのモデル選択が「なんとなく4o」「とりあえず一番高いプラン」になっていないでしょうか。実は、o1やo3のような推論モデルとGPT‑4oの違いは、数学やコーディングの正答率だけでなく、レポートの質、ミスの件数、そして毎月のAIコストにそのまま直結します。推論特化のo3を入れれば万能になるわけではなく、どの業務フローのどの段階を、どのモデルに任せるかを間違えると、FreeやPlusでもできるタスクにProやBusinessの費用を垂れ流すことになります。この記事では、o1とo3シリーズ、o3 miniやo4 mini、GPT‑4oを比較表と具体的な業務シーンで整理し、「推論能力」「速度」「料金」「制限」を一度で把握できるようにします。そのうえで、マーケ、バックオフィス、開発・研究ごとに、4oで十分なタスクとo3に切り替えるべきタスクを切り分け、Reasoning Effortやo3 mini Highを検算係として組み込む実務ロジックを示します。さらに、「ChatGPT o3 とは」「使い方」「料金」「制限」「消えた・切り替えできない」といった再検索ワードもまとめて解決します。ここでモデル選定と業務設計の軸を持たないまま導入を進めることこそが、最も高くつく損失になります。
目次
はじめに ChatGPTのo1とo3と推論モデルがもたらす、本当に“仕事が変わる瞬間”とは?
「AIを入れたのに、社内の評価は“便利だけど決め手に欠ける”で止まってしまう」
この一歩先に連れて行けるかどうかを分けるのが、o1やo3に代表される推論モデルです。単なる文章生成ツールから、「一緒に考える相棒」へ格上げされる瞬間がここで生まれます。
中小企業の現場を見ていると、最初はGPT‑4oでメールや資料作成が爆速になり、次に「複雑な見積もり条件」「法律や規程の解釈」「バグの原因追跡」といった“頭を使うタスク”で壁にぶつかるケースが目立ちます。
この壁を越えるための選択肢が、o1シリーズやo3シリーズの推論能力です。
ChatGPTのo1とo3が登場して変わったのは?一言で語れる衝撃
一言でいえば、「AIが考え方ごとレビューしてくれる時代になった」ことです。
以前のモデルは、速くて器用な“優秀な事務スタッフ”のイメージでした。
そこにo1やo3が加わり、次のような変化が起きています。
| 視点 | 従来の万能モデル(例 GPT‑4o) | 推論モデル(o1・o3) |
|---|---|---|
| 得意なタスク | 文章生成、要約、アイデア出し | 数学、コーディング、条件分岐だらけの問題 |
| 考え方 | 結論をすばやく出す | 中間の思考プロセスを丁寧にたどる |
| 使い心地 | サクサク会話 | じっくり相談、検算・レビュー向き |
特に「なぜそう判断したのか」をステップごとに説明させると、社内の教育・ナレッジ共有にまで使えるレベルの回答が返ってきます。ここが、単なる自動化ツールではなく“思考を外注するツール”になったポイントです。
推論モデルと万能モデルの違いをリアル解剖 数学・コーディング・長文思考、その決定的な差
現場で差を痛感しやすいのが、次の3ジャンルです。
-
数学・統計タスク
売上予測のロジックや、条件付きの割引計算など、途中式が長くなる問題で、推論モデルはミスの少なさと説明力で優位に立ちます。
-
コーディング・デバッグ
GPT‑4oが「とりあえず動くコード」を最速で出す一方、o3系は「なぜバグるのか」「この設計で将来どこが詰むか」といった論理のほつれを丁寧に指摘しやすいです。
-
長文思考・業務フロー設計
就業規則、契約条件、社内ルールなど、例外だらけの文章を読み解くときに、推論モデルは「この前提ならパターンA」「この条件ならパターンB」と枝分かれを整理するのが得意です。
体感としては、万能モデルが“とにかく早く案を出す役”、推論モデルが“最後の詰めと検算をする役”と捉えると選びやすくなります。
いま押さえたい ChatGPTのo1やo3や推論モデルの再検索ワードと読者の「モヤモヤ」リスト
検索ログを眺めると、ユーザーのモヤモヤはかなり共通しています。よくある疑問を整理すると、どこから読み進めるべきかが見えてきます。
-
料金や制限に関するモヤモヤ
- o3やo3 miniは無料でどこまで使えるのか
- PlusやPro、Businessで使えるモデルと回数の違いはどう整理すべきか
- API利用時のコストが、現場のタスクで本当に回収できるのか
-
モデル比較に関するモヤモヤ
- o1とo3、そしてGPT‑4oやo4 miniの違いが、実務でどこまで体感できるのか
- 数学やコーディングでの“正答率”と、日常業務での“使い勝手”のどちらを優先すべきか
- 「とりあえず一番高いモデル」で走るリスクはどこに出るのか
-
運用・トラブルに関するモヤモヤ
- 途中でo3が使えなくなる制限到達のサインと、o3 miniやo4 miniへの切り替え基準
- PCやスマホアプリでモデルが突然消えた・選べないときのチェックポイント
- 情報漏洩やJailbreak対策を踏まえたBusinessプランやSafeguardsの必要性
-
業務設計に関するモヤモヤ
- 経理や法務など、ミスできない部署で推論モデルをどこまで信用してよいか
- マーケやSEOで、ペルソナ設計や構成案の“論理チェック係”としてどう組み込むか
- 4oをおしゃべり担当、o3 miniを検算担当にしたときの具体的なフロー設計
これらのモヤモヤをそのまま放置すると、「AIは便利だけど、最後は人間が全部確認だから結局しんどい」という評価で止まってしまいます。
次の章からは、このギャップを埋めるために、モデル比較と業務フロー設計を一気に整理していきます。
ChatGPTのo1やo3やGPT‑4oの違いがまるわかり!瞬間比較で見抜く“推論力”の本質
頭の中で会議をしてから答えてくれるのがo3系、反射神経で即答してくれるのがGPT‑4o系、とイメージすると整理しやすくなります。まずはよく使う4モデルを一気に比べてみます。
ChatGPTのo3やo3 miniやGPT‑4oやo4 miniを比べてわかる「推論」も「スピード」も納得の比較表
下の表は、日々の業務で体感しやすい「推論能力」「速度」「コスト感」でのざっくり比較です。
| モデル | 推論能力 | 速度 | コスト感 | 向いているタスク |
|---|---|---|---|---|
| o3 | 最高クラス | 中〜やや遅め | 高め | 複雑な条件整理、重要なコードレビュー、数理問題 |
| o3 mini | 高い | 中 | 中 | 長文の論理チェック、仕様書の検算、テストケース設計 |
| GPT‑4o | 高いが“浅め” | 速い | 中 | 企画書作成、マーケ原稿、ライトなコーディング |
| o4 mini | 中〜高 | 非常に速い | 低〜中 | チャット窓口、要約、社内FAQの一次回答 |
ポイントは、o3は「正確さ優先」、GPT‑4oとo4 miniは「回数とスピード優先」という役割分担になっていることです。中小企業の現場では、4oやo4 miniを標準にしつつ、「ここだけはミスが致命傷」という部分にo3やo3 miniを差し込むとバランスが取りやすくなります。
ChatGPTのo1シリーズとo3シリーズの“思考の深さ”や幻覚耐性を比べて見えてくる狙い目モデル
o1とo3はどちらも推論特化ですが、性格が少し違います。
-
o1系
- 思考の深さ: 深いが「考え込み」がち
- 幻覚耐性: 従来より改善だが、タスク設計次第でブレやすい
- 向き: 研究寄りの実験、アイデア探索、プロトタイピング
-
o3系
- 思考の深さ: 深さと安定性のバランスが良い
- 幻覚耐性: 数学やコードなど「答えがはっきりしている問題」で特に安定
- 向き: 本番運用に近い業務フローへの組み込み、検証・検算役
業務で“狙い目”になるのはo3 miniです。理由は、推論能力が高いのにレスポンスとコストが現実的で、「4oで作る」「o3 mini Highで検算する」という二段構えの運用にきれいにハマるからです。
ChatGPT FreeやPlusやProやBusinessやAPIで使えるモデルと料金・制限をマルっと整理
「どのプランならどのモデルをどれくらい使えるのか」が分からないと、社内稟議が止まりがちです。ここでは詳細単価ではなく、利用可能モデルと“体感レベル”の制限をまとめます。
| プラン | 主な利用モデル | 推論モデル利用感 | 想定ユーザー |
|---|---|---|---|
| Free | GPT‑4o中心 | 推論モデルは限定的・テスト用レベル | 個人の試験利用 |
| Plus | GPT‑4o系+一部推論モデル | 日常業務で試せるが回数は控えめ | 個人事業主、担当者レベル |
| Pro | 4o系+o3系フル活用しやすい | 推論モデルを業務標準にしやすい | マネージャー、パワーユーザー |
| Business | 組織単位で4o系+o3系 | 制限緩和+管理機能が重要 | 中小〜大企業の部門導入 |
| API | 全モデルを従量課金で利用 | 自社システムやクラウドへ組み込み | 開発チーム、SaaS事業者 |
ざっくり整理すると、まずはPlusで4oを標準化し、推論タスクが増えてきたらProかBusiness、さらにワークフローに深く組み込む段階でAPI、というステップが現場ではスムーズです。無料だけで何とかしようとすると、ちょうど推論能力を試したいタイミングで回数制限にぶつかり、「AIは使えない」というレッテルになりがちなので注意してください。
ChatGPTのo3とは?現場の声でわかる「読み方」「特徴」「使える回数」まるごとガイド
頭を抱えるようなロジックの穴を、人より速く見つけてくれるAIがほしい──そんな時に刺さるのがo3です。マーケ、バックオフィス、開発の現場で「最後の検算係」として置いておくと、トラブル率が目に見えて下がります。
ChatGPTのo3やo3 miniの読み方と位置づけ 推論に特化した“検算係”としての扱い方
読み方はシンプルに「オースリー」です。GPT‑4oが「何でも屋の営業担当」だとしたら、o3は論理をとことん詰める参謀役というイメージです。
特に次のようなタスクで威力を発揮します。
-
数学や統計を伴う試算のチェック
-
条件分岐が複雑な就業規則・契約条件の整理
-
既存コードのバグ洗い出しや設計レビュー
-
長文レポートの筋の通り方・矛盾の検証
o3 miniは、その参謀を「軽量化した版」で、推論能力は高めに保ちつつコストと速度を優先したモデルとして位置づけると選びやすくなります。日常の相談やドラフト段階はGPT‑4oやo4 mini、本番前の検算だけo3 mini Highモードで通す、という運用が現場では安定しやすいです。
ChatGPTのo3が何回まで使えるか?無料・Pro・Business・APIで変わる制限のリアル
o3は推論に多くの計算資源を使うため、利用できる回数やトークン量に上限が設けられやすいモデルです。ざっくりのイメージを整理すると次のようになります。
| プラン種別 | o3利用の傾向 | 現場での使いどころ |
|---|---|---|
| Free | 使えても回数・長さはかなり絞られる | 体験・簡単な検算だけ |
| Plus/Pro | 日常業務で使えるが高負荷連投は制限されがち | レポート最終チェック、コードレビュー |
| Business | 制限が緩めで安定利用を想定 | チーム標準フローへの組み込み |
| API | 完全に従量課金。制限は料金と設計次第 | 自社サービスやRPAとの統合 |
実務上のコツは、「全部をo3でやらない」ことです。記事作成なら、構成案や下書きはGPT‑4o、最終的な論理チェックだけo3に投げる。経理なら、仕訳案の生成は軽いモデル、月次決算の整合性だけo3で確認、といった役割分担にすると、回数制限にぶつかりにくくなります。
ChatGPTのo3 ProやBusinessやAPIの料金感と、コストを回収できるシーンはココ!
o3は高性能な分、1回あたりのコストは汎用モデルより重くなりがちです。ただし、使い方がハマるとあっさり元を取ります。料金感は「ProやBusinessでは月額に含まれつつ、ヘビーに使うと追加コストや制限が見えてくる」「APIではトークン課金で使った分だけ請求される」という構造だと捉えると判断しやすくなります。
特に投資対効果が出やすいのは、次のようなシーンです。
-
高単価ミスの防止
契約書の条件抜け、請求書の誤金額、セキュリティ設計の見落としなど、一発で数十万円以上の損失が出るタスクの検算に使う。
-
専門人材の時間圧縮
エンジニアや税理士レベルでないと気付きにくいロジックの穴を、o3に一次チェックさせ、人は最終判断だけに集中する。
-
社内標準フローへの組み込み
マーケ記事の公開前チェック、勤怠データの異常検知、インシデント報告の整合性確認など、「毎月必ず発生するタスク」に組み込む。
現場感としては、「1件でも大きな事故を防げば、数カ月分の利用料はすぐ回収」という位置付けになります。安さでモデルを選ぶのではなく、「どの業務なら推論モデルの料金を利益に変えられるか」を起点に設計することが、中小企業にとっての勝ちパターンだと考えています。
GPT‑4oとChatGPTのo3をシーンで使い分ける!万能型や推論特化型の鉄板戦略
「とりあえず一番いいモデル」で選ぶ時代は終わりつつあります。いま必要なのは、業務フロー単位で4oとo3の“出番”を決めることです。
ChatGPTの4oとo3をスピードや論理の粘り強さで比較 迷わない選び方
まず、日常業務で迷いがちなポイントをざっくり整理します。
| 観点 | GPT‑4o | o3 |
|---|---|---|
| 得意分野 | 企画・要約・ドラフト作成・会話 | 数学・コード・条件分岐・検証 |
| 速度 | かなり速い | 4oより遅いが安定 |
| 推論能力 | 実務レベルで高い | 複雑問題でさらに粘る |
| 幻覚対策 | 良好 | より慎重で検算向き |
| 向くタスク | 初稿作成・ブレスト | 最終チェック・難問対応 |
実務では、次のように切り分けると迷いません。
-
4o向き
- 企画書のたたき台
- ブログ構成案
- 社内マニュアルのドラフト
- チャット対応の一次回答
-
o3向き
- 複雑なIF条件が絡む経理オペレーションの検算
- バグ箇所特定やアルゴリズムの見直し
- 長文レポートの論理破綻チェック
- セキュリティ設計やリスク洗い出し
「まず4oで形を作り、崩れてはいけない部分だけo3で絞り込む」という二段構えが、現場で最もコスパが良くなりやすいパターンです。
ChatGPTのo3やo4 miniやo3 mini 低価格で推論能力を賢く狙うなら
中小企業やスタートアップでは、推論能力とコストのバランスが勝負になります。そこでキーになるのがo4 miniとo3 miniです。
| モデル | 位置づけ | 使いどころ |
|---|---|---|
| o4 mini | 4oの軽量版 | 毎日ガンガン回す定常業務 |
| o3 mini Low | o3の軽量推論 | チェックはしたいがコストも抑えたい場面 |
| o3 mini High | 検算特化 | 数学・コード・ロジックの最終確認 |
現場でおすすめしやすいのは次の組み合わせです。
-
マーケ・SEO
- 執筆ドラフト: o4 miniまたは4o
- 見出し構成の論理チェック: o3 mini High
-
バックオフィス
- 手順マニュアル整理: o4 mini
- 条件分岐や締切計算の検証: o3 mini High
-
開発・研究
- 叩き台コードやテストケース生成: 4o
- 本番投入前のロジック確認: o3またはo3 mini High
「o3を常時使う」のではなく、「o3 miniをピンポイントで差し込む」イメージを持つと、クラウド利用料を抑えつつ推論能力を確保しやすくなります。
1番高いモデルこそ正解はもう古い?4oとo3のハイブリッド運用で成果を最大化
実務でよくある失敗は、次のような流れです。
-
PoCでは4oだけで簡単なタスクを試し「AIすごい」と高評価
-
そのまま難しい数理・法務・セキュリティ領域に拡大
-
ロジック抜けや幻覚が増え、現場が「AIは危ない」と評価を下げる
多くの場合、問題はモデルそのものより役割設計の欠如にあります。おすすめは、AIに「役職」を与える運用です。
-
4o / o4 mini = おしゃべり担当・ドラフト担当
-
o3 / o3 mini High = 検算担当・監査担当
この役割分担を決めたうえで、
- 4oで案を作る
- リスクの高い箇所だけo3で再評価する
- 最後に人間が「社内ルールや現場感覚」に照らして承認する
という三段階フローにすると、推論能力を最大限活用しながらも、人間の判断を外さない運用に近づきます。
AIを「何でも屋」にせず、業務の中で専門職の一人として配置する設計こそ、4oとo3を使いこなす近道になります。
実務でありがちなAI導入の失敗をChatGPTのo1やo3や推論モデルで大逆転!
「最初のデモはうまくいったのに、本番で事故る」
AI導入の現場で一番多い声です。原因の多くは、モデルの性能よりもタスクと推論モデルのズレにあります。
最初はGPT‑4oで順調だったのに崩れるレポートやコード…そんな「業務落とし穴」の共通パターン
デモ段階ではGPT‑4oだけで問題なく回ります。ところが、運用が始まると次のような崩れ方をします。
-
月次レポート
- 単純な要約までは綺麗
- 途中から「前月比」「条件分岐」を含む分析で数字のつじつまが合わなくなる
-
コード生成
- 小さな関数は正確
- モジュールをまたぐ修正や例外処理が増えた瞬間にバグが増殖
-
業務フロー設計
- 手順書のドラフトは優秀
- パターン分岐が増えると、必須チェックが抜けて事故につながる
共通しているのは、「表現はうまいが、論理の検算を誰もしていない」状態になっていることです。
汎用モデルだけで回そうとすると、ここで必ず天井にぶつかります。
ChatGPTのo3 mini Highで“検算モード”を挟むだけで救えた現場トラブル例
この天井を一気に破るのが、o3 miniのHigh設定を検算専用モデルとして差し込む運用です。イメージは次のような役割分担です。
| 段階 | モデル | 役割 |
|---|---|---|
| ① たたき台作成 | GPT‑4o | 速く広くアイデア・ドラフト生成 |
| ② 検算・論理チェック | o3 mini High | 数字・条件分岐・一貫性の検証 |
| ③ 最終判断 | 人間 | 意思決定と責任範囲の確定 |
具体的には、次のようなプロンプトで「検算モード」を明示します。
-
数値レポート
- 「以下のレポートについて、表の合計・前月比・グラフ説明の整合性を、1行ずつ検証し、矛盾があれば列番号と理由を示してください」
-
コードレビュー
- 「この変更で想定されるバグパターンと、境界値・例外系テストケースを列挙し、不足しているテストを指摘してください」
ポイントは、o3 miniに“考えさせるタスクだけ”を渡すことです。文章の言い換えや図表の整形は4oに任せ、o3 miniはあくまで「鬼チェック担当」にすることで、コストもレスポンスも現実的な範囲に収まります。
数学・理数・バイオ・サイバーセキュリティなど失敗できない分野での推論モデル活用術
数学・理数・バイオ・サイバーセキュリティといった領域では、1つの誤りがそのままリスクに直結します。ここでは、最初から推論モデル前提の設計に切り替えたほうが安全です。
-
数学・アルゴリズム
- 証明・最適化・動的計画法などはo3またはo1で「途中式まで出させる」
- 4oは図解や自然言語での解説に専念させる
-
バイオ・生物系の研究メモ
- 仮説のロジックチェック、前提条件の洗い出しはo3 mini High
- 用語整理や図表化は4oでスピード重視
-
サイバーセキュリティ
- 攻撃パターンやCTF問題の解析は推論モデル
- レポート整形や顧客向け説明資料は汎用モデル
特にセキュリティでは、Jailbreak誘導やunsafeなコード生成のリスクもあるため、Safeguards設定と組み合わせて推論モデルを「守りのAI」として配置する設計が重要です。
AIを「何でも屋」として1体だけ導入するほど、現場は疲弊します。
4oをおしゃべりとドラフトの担当、o3やo1を検算と高リスク領域の担当と割り切ることで、現場のストレスも、経営のリスクも一気に下がります。これが、業務フロー単位でAIを設計する側から見た、推論モデルの本当の使いどころです。
部署ごとで変わる!ChatGPTのo1とo3が“刺さる仕事”や4oだけで十分な仕事
部署ごとに仕事の「脳の使い方」が違うように、AIモデルも向き不向きがはっきり分かれます。ざっくり整理すると次のイメージです。
| 部署/シーン | 4oで十分な仕事 | o1 o3が刺さる仕事 |
|---|---|---|
| 経営・マーケ | 企画メモ作成 SNS文案 | 戦略整理 ペルソナ精査 |
| 経理・労務・法務 | 定型メール下書き | 条件分岐チェック 規程解釈 |
| エンジニア・研究 | 雛形コード生成 | 高度アルゴリズム検討 検証 |
経営やマーケやSEO現場でChatGPTのo3 miniによるペルソナ設計や論理チェック活用法
マーケ現場では、情報生成は4oに任せ、意思決定前の「論理の最後の一押し」だけo3 mini Highに振ると安定します。
具体的な流れは次の通りです。
-
4oでペルソナ案やLP構成を複数パターン生成
-
o3 mini Highに「前提条件」と「ペルソナ像」を渡し、矛盾点と抜け漏れを洗い出してもらう
-
SEO記事では、見出し構成は4o、骨組みチェックをo3 mini Highに担当させる
この二段構えにするだけで、「読んだら破綻している戦略資料」や「ペルソナがふわっとしたまま走り出す」事故が目に見えて減ります。
経理・労務・人事・法務でChatGPTの推論モデルをミス削減に活かすテクニック
バックオフィスは、条件分岐と締切管理のミスが致命傷になりやすい領域です。ここではo3 miniの推論能力を、次のように「ダブルチェック専用」として使うと効きます。
-
就業規則や契約書の該当条文をコピペ
-
自社ケースを箇条書きにして「条文と照らして条件判定だけして」と指示
-
給与計算や請求書チェックでは「入力値とルールを渡し、計算手順と結果を説明させる」
重要なのは、最終判断は人間が行う前提で、手計算を代わりにさせるイメージで使うことです。丸投げではなく「検算」として組み込むことで、ヒューマンエラーをかなり吸収できます。
エンジニアや研究者がコーディングやCTFや数理最適化でChatGPTのo3を使い倒す方法
開発や研究では、4oのコード生成だけに頼ると、「動くけれど設計が甘い」状態になりがちです。ここでo3やo1の出番です。
-
コーディング
- 雛形やライブラリ選定は4o
- 重要ロジックの計算過程や境界条件チェックはo3 High
-
CTFや脆弱性調査
- 問題文の分解と攻撃シナリオ案出しをo3
- 実装は人間+4oで高速化
-
数理最適化や研究アイデア
- 前提条件と制約をすべて列挙させ、o3に「抜けている制約」を指摘させる
o3は回答速度よりも思考の一貫性と説明の丁寧さに強みがあります。結果だけでなく「なぜそうなるか」を問うことで、レビュー兼ペアプロ相手として機能します。
現場で多発するプロンプト設計やReasoning Effort(Low/Medium/High)のミスをつぶすには?
推論モデルを入れてもうまくいかない現場を見ると、共通して次の3つでつまずいています。
-
依頼がざっくりしすぎていて、「何を守ればいいか」がモデルに伝わっていない
-
Reasoning Effortを常にHighにし、軽い相談にも重い思考コストをかけてしまう
-
逆に、複雑な条件判定なのにLowのまま使い、途中で論理が迷子になる
現場でお勧めしているシンプルなルールはこの表です。
| タスクの重さ | 目安のモデル | Reasoning Effort |
|---|---|---|
| アイデア出し 下書き | 4o | Low |
| 重要文書の論理チェック | o3 mini | Medium |
| 数学・コードの厳密検証 | o3 o1 | High |
依頼前に「これは社内でやれば10分か1時間か」を一度考え、その感覚をReasoning Effortに対応させると、モデル選択の失敗が一気に減ります。業界の現場を見ていても、AIの善し悪しより、この設計ミスの方が成果を左右していると感じています。
ChatGPTのo1やo3や推論モデルを業務フローに組み込む“必勝パターン”
高性能なモデルを入れたのに「思ったほど成果が出ない」と相談されることが増えました。共通するのは、業務フローに合わせた役割分担を決めず、全部を1つのモデルに丸投げしていることです。ここでは、現場で安定して回りやすい“必勝パターン”だけに絞って整理します。
「おしゃべり担当4o」と「検算担当o3 mini」でAIチームをつくる運用アイデア
人間のチームと同じで、AIも役割を分けた方が圧倒的に安定します。おすすめは次の2ポジションです。
-
おしゃべり担当:GPT‑4o(またはo4 mini)
- 要件の整理、ブレスト、たたき台の文章生成を高速に担当
-
検算担当:o3 mini(Reasoning Effort:High推奨)
- ロジックチェック、計算、コードレビューなどの推論タスクを担当
この2つを「同じスレッドでダラダラ使う」のではなく、タスクごとにスレッドを分けて引き継ぐのがポイントです。
| 役割 | モデル例 | 主なタスク |
|---|---|---|
| おしゃべり担当 | GPT‑4o,o4 mini | 要件整理,要約,ドラフト生成 |
| 検算担当 | o3 mini High | 数学,条件分岐,コード検証,規程チェック |
プロンプトには必ず「あなたは検算担当です」「あなたはドラフト作成担当です」と役割名を明示すると、回答のブレが減り、幻覚率も体感で下がります。
1つのタスクを分割し どの段階をどのモデルへ任せるか決める実践的手順
レポート作成や新規機能の設計など、複雑な仕事ほど段階分割+モデル割り当てが効きます。現場で使いやすい手順は次の通りです。
- タスクを3〜5段階に分解する
例:要件整理→情報収集→ドラフト作成→論理チェック→最終調整 - 各段階で「失敗すると困る度合い」と「スピード重視度」を評価する
- 推論が重い段階だけo3系に切り替える
| 段階 | 失敗リスク | スピード重視 | 推奨モデル | Reasoning Effort |
|---|---|---|---|---|
| 要件整理 | 中 | 高 | GPT‑4o | Low〜Medium |
| 情報整理 | 中 | 中 | GPT‑4o | Medium |
| ドラフト作成 | 低 | 高 | GPT‑4o,o4 mini | Low |
| 論理チェック | 高 | 中 | o3 mini | High |
| 最終調整 | 中 | 中 | GPT‑4o | Medium |
よくある失敗が、「全部Highにする」「全部o3にする」パターンです。これではコストもレイテンシも跳ね上がります。リスクが高い段階だけ推論モデルにスイッチすることが、実務と経理双方にやさしい設計になります。
シャドーAIや情報漏洩リスクを防ぐルール作り BusinessプランやJailbreak対策やSafeguards活用
モデル選定と同じくらい重要なのが、情報ガバナンスの設計です。ここを曖昧にすると、メンバーが個人アカウントのクラウドサービスや無料アプリでシャドーAI利用を始め、気づいたら顧客情報や契約書が外部に出ていた、という事態になりかねません。
最低限押さえておきたいルールと仕組みは次の通りです。
-
アカウントポリシー
- 業務利用はBusinessプランや組織管理されたAPIのみ許可
- 個人の無料アカウントでの業務利用は禁止
-
入力してよいデータの線引き
- 氏名,住所,請求書番号などの個人情報や機密ソースコードは「原則そのまま貼らない」
- 必要な場合は、マスキングや要約をかけてから投入
-
Jailbreak対策とSafeguards
- 「モデルの制限を外す指示」をしてはいけないことを明文化
- 安全フィルタを意図的に回避しない、というルールを教育
- 管理者側でSafeguardsや監査ログを有効化し、不審なプロンプトを定期レビュー
セキュリティルールは、「禁止事項の一覧」だけだと現場に浸透しません。安全に攻めてよいプロンプト例とやってはいけないNG例をセットでテンプレート化し、そこにo3 miniやo1など推論モデルに向けたサンプルを含めると、学習コストを抑えつつリスクを下げられます。
AIを単なるツールではなく「社内の新入社員」として扱い、役割と権限とガードレールを最初に決めておく。これが、o1やo3の推論能力を安心してフル活用するための、いちばん現実的な近道になります。
ChatGPTのo3が消えた・切り替えできない時の「困った」を秒速解決!チェックリスト大全
推論モデルを業務に組み込んだ途端、「昨日まであったo3が消えた」「o3 miniに切り替えられない」と止まるケースが一気に増えます。現場でよく詰まるポイントだけを、原因ごとに秒速でつぶせるチェックリストとしてまとめます。
PCブラウザでChatGPTのo3が表示されない時に確認すべきアカウントや設定
PCで突然o3が見えなくなる時は、ほぼ設定かプランの問題です。上から順に確認すると早いです。
-
ログインアカウントの取り違え
- 個人用と会社用、Freeと有料のアカウントが混在しているケースがよくあります。
- ブラウザ右上のメールアドレスを確認し、意図したアカウントかチェックします。
-
プランと利用可能モデルの整合性
- Freeではo3が選べず、PlusやPro、Businessで開放されるパターンがあります。
- 社内で「契約はしているつもり」でも、実際は請求情報未登録のためFree扱いになっている例もあります。
-
モデル選択UIの表示モード
- 画面左上のモデル名のプルダウンがたたまれており、「おすすめ」表示だけで探していると見落とします。
- プルダウンを開き、「すべてのモデル」や「推論モデル」カテゴリーを展開して探してみてください。
-
ブラウザ環境の不整合
- 拡張機能の広告ブロッカーやセキュリティアドオンがUIの一部を隠すことがあります。
- シークレットウィンドウや別ブラウザで開き、表示が変わるか確認します。
-
組織側の制限ポリシー
- 管理者がBusinessプランで利用モデルを制限していると、ユーザー側からは「消えた」ように見えます。
- 情シスや管理者に「利用可能モデルの制限設定がないか」を確認してもらうのが近道です。
スマホアプリでChatGPTのo3 miniへ切り替わらない時の原因とトラブル解決ワザ
スマホアプリは、PCよりも「どのアカウントで、どのプランか」が見えにくく、トラブルが起きやすいです。
-
アプリ内アカウントとブラウザアカウントのズレ
- PCでは有料、スマホは昔のFreeアカウントでログインしているケースが頻発します。
- アプリの設定→アカウント情報からメールアドレスを確認し、PCと一致しているか確認します。
-
アプリのバージョン遅れ
- 古いバージョンだと、新しい推論モデルのUIが出ないことがあります。
- ストアから最新バージョンへ更新し、アプリ再起動まで行います。
-
モデル切り替え操作の勘違い
- チャット画面上部のモデル名をタップすると一覧が出ますが、
「おすすめ」タブだけ見ているとo3 miniを見逃します。 - 一覧から「すべてのモデル」や「推論」系カテゴリを選び直してみてください。
- チャット画面上部のモデル名をタップすると一覧が出ますが、
-
モバイル回線の不安定さ
- 回線が不安定な状態だと、モデル一覧の取得に失敗してデフォルトモデルのみ表示されることがあります。
- 一度Wi-Fiに切り替えるか、場所を変えて再読み込みすると改善するケースが多いです。
ChatGPTのo3が途中で使えなくなる“制限到達”のサインや回避策(o3 mini・o4 mini代替も)
推論モデルは、推論能力が高い分だけリソース制限もタイトです。業務の途中で突然使えなくなる原因の多くは、この制限到達です。
よく出るサイン
-
新しいチャットでo3を選ぼうとしても選択肢から消えている
-
「このモデルの利用上限に達しました」系のメッセージが出る
-
同じアカウントで、PCもスマホも一斉にo3が出なくなる
この状態になった時の、現場での現実的な打ち手は次の通りです。
-
o3 mini Highへ切り替える
- 論理チェックやコードレビューなど、推論の「検算」が目的なら、o3 mini Highでも十分なケースが多いです。
- コストと制限のバランスが良く、レポートの最終チェック役として組み込みやすいモデルです。
-
o4 miniや4oとの「二段構え」運用に切り替える
- 長文のドラフト作成や一次情報の整理は4oやo4 miniに任せ、
最後の整合性チェックだけをo3またはo3 mini Highに振ると、制限到達を大きく遅らせられます。
- 長文のドラフト作成や一次情報の整理は4oやo4 miniに任せ、
-
プロンプトの設計を見直す
- 一度のメッセージで大量の条件分岐や長大なデータを投げ込むと、推論負荷が跳ね上がります。
- 業務フローを分割し、「要約→検算→最終出力」と3段階くらいに分けるだけで、消費をかなり抑えられます。
-
プランとAPIの併用を検討する
- ProやBusinessでのUI利用だけでなく、API側でo3 miniを使うと、
バッチ処理や夜間の自動検算に回せるため、日中のUI側の上限を温存しやすくなります。
- ProやBusinessでのUI利用だけでなく、API側でo3 miniを使うと、
-
制限到達を前提にした業務設計に変える
- 「重要タスクは午前中にo3で検算」「午後は4o中心」など、
モデルの利用ピークをコントロールするだけで、現場のストレスは大きく下がります。
- 「重要タスクは午前中にo3で検算」「午後は4o中心」など、
推論モデルは「賢い1人の部下」ではなく、「検算とチェックに特化したチームメンバー」として位置づけると、制限やトラブルにも振り回されにくくなります。表示が消えた瞬間に焦るのではなく、今回のチェックリストを業務マニュアルに組み込んでおくことで、現場の停止時間をほぼゼロに近づけられます。
宇井和朗が徹底解説!8万社時代の中小企業がChatGPTのo1やo3や推論モデルと付き合う最前線
Webやバックオフィスや開発の相談に日々向き合っていると、「どのモデルを入れるか」より「どこにどう組み込むか」で成果が9割決まると感じます。便利なおもちゃとして触る段階は終わり、いま求められているのは“黙って売上と工数を変えてくれるAIの置き方”です。
WebマーケやSEOやMEOやAIO現場で推論モデルはどう“使われているのか”リアル調査
Webマーケの現場で推論特化モデルが刺さっているのは、「答えをゼロから書かせる場面」よりも「人が書いた案を論理で叩く場面」です。
代表的な組み合わせは次のような形です。
-
4oやo4 miniで記事構成や広告案を大量生成
-
o3 mini Highで「ペルソナとのズレ」「検索意図の抜け」「論理ジャンプ」をチェック
-
最後は人がトンマナとリスクだけを確認して公開
この“おしゃべり役+検算役”の二刀流にすると、SEOやMEOのコンテンツ制作で手戻りと炎上リスクを同時に削ることができます。逆に、最初からo3で全部書かせると、時間もコストも重くなり、現場ではほぼ続きません。
Web・集客系で推論モデルが効きやすいのは、次のようなタスクです。
-
キーワードセットごとの検索意図の分類
-
店舗口コミの大量レビューから「本当の強み・弱み」を抽出
-
競合サイトの構成を読み解き、自社が狙うべき空白領域を整理
ここでは“深く読む力”がものを言うため、o3やo1を検証係として混ぜるだけで、施策の打ち間違いがかなり減ります。
公式情報で満足しない現場の「困った」や「真の選び方」とそれに効くモデル戦略
実務でよくあるのは、仕様表だけ見てモデルを選び、次のような壁にぶつかるパターンです。
-
4oだけで高度な経理・法務チェックまで任せて、細かい条件分岐でミスが出る
-
o3を常用してレスポンスが重くなり、現場から「AIは遅い」と評価される
-
PlusとPro、Business、APIの料金や制限を曖昧なまま導入し、月末に請求で揉める
こうした“あるある”を避けるために、まず押さえたいのがプランとモデルの対応関係です。
| 観点 | 通常タスクの軸 | 推論が重いタスクの軸 |
|---|---|---|
| 個人無料 | 4o中心 | o3 miniをピンポイント利用 |
| Plus | 4o+o4 mini | 必要時のみo3 mini High |
| Pro・Business | 4o常用 | o3・o1を検算・レビュー専任に |
| API | 4o系で自動化 | バッチ処理でo3を検証用に |
ポイントは「最強モデルを1本選ぶ」のではなく、業務フローごとに“この段階は4o、この段階はo3”と役割を割り振ることです。特に中小企業では、1つのチャットに全部やらせようとした瞬間に、コストも責任範囲もあいまいになります。
経理・労務・法務では、まず4oでドラフトを作り、o3 mini Highで「条文や規程との整合性」だけをチェックさせる設計にすると、誤りリスクとAI拒否(社内の心理的拒否)の両方を抑えられます。
AIを単なる便利ツールじゃ終わらせない 組織力まで引き上げる仕組み化ポイント
AIを“便利な人”で終わらせるか、“組織の標準装備”にできるかは、次の3点で決まります。
-
モデルごとに役職名をつける
例:4oは「ドラフト係」、o3 miniは「検算係」、o1は「研究相談役」
-
Reasoning Effortのルールを決める
数学やセキュリティ診断のような高リスクタスクだけHighを許可し、それ以外はMediumまでに固定すると、速度とコストのバランスが安定します。
-
シャドーAIを防ぐガイドラインを用意する
BusinessプランやSafeguardsを活用しつつ、「顧客データを外部APIに入れる前に必ずこのチェックを通す」といった具体的な手順を明文化しておくことが重要です。
一度、部署ごとに「4oで十分なタスク」と「o3やo1を必ず噛ませるタスク」を棚卸しすると、AI導入の議論が“感覚論”から“設計図”に変わります。ここまで落とし込めた組織から、静かに生産性と精度の差が開いていく流れを強く感じています。
この記事を書いた理由
著者 – 宇井 和朗(株式会社アシスト 代表)
本記事は、私がクライアントと日々向き合う中で蓄積してきた経験と知見を整理し、生成AIに任せず自分の手でまとめた内容です。
創業期からWeb集客とITツール導入を一体で設計してきた中で、ここ数年は「とりあえずGPT‑4o」「一番高いプランなら安心」という導入が、費用対効果を大きく損ねるケースを何度も見てきました。マーケティング部門では、4oだけで十分な文章生成タスクに高額プランをあてている一方で、論理検証が必要なレポートやSEO戦略の骨組みには推論モデルを使わず、ミスが増えている企業もあります。バックオフィスでは、経理・労務のチェック工程にo3 mini Highを挟むだけで、確認工数とヒューマンエラーが目に見えて減った例もありました。
また、現場からは「o3が突然消えた」「スマホでo3 miniに切り替わらない」といった相談も頻繁に届きます。8万社規模でホームページとAI活用を支援する中で、モデルごとの役割分担と業務フローへの落とし込みを解説する必要性を強く感じ、この記事ではo1・o3・4oの比較だけでなく、「どの仕事のどの段階をどのモデルに任せるのか」を具体的に示しました。AIを単なる流行のツールで終わらせず、コストと品質の両面で成果につなげてほしい——それが本記事を書いた理由です。
🧰 お困りごとの解決に
最近更新した記事
 シャープ冷蔵庫で製氷できないときの原因と自分でできる確認手順💡 結論(要点まとめ)シャープ製冷蔵庫で氷ができない・落ちてこない原因を解説。製氷停止設定や氷の偏り、シ…
 三菱電機エアコンの暖房試運転の手順と温風が出ない時の確認項目💡 結論(要点まとめ)三菱電機製エアコン(霧ヶ峰など)の暖房試運転の手順と確認ポイントを解説。試運転に適…
 テレビの修理費用の確認方法|主要メーカーの窓口と買い替え判断基準💡 結論(要点まとめ)テレビが映らない・故障した際の確認事項と、主要メーカーの修理料金の確認先を解説。型…
 電気メーターの見方と液晶画面の数字・単位、買電・売電の表示を整理💡 結論(要点まとめ)電気メーター(スマートメーター)の液晶画面に表示される数字や単位の見方を整理。買電…
 佐川急便の集荷申し込み方法と手順|伝票の準備から当日の流れまで💡 結論(要点まとめ)佐川急便の集荷申し込み手順を整理。通常の集荷手数料は原則無料で、運賃は別途必要です…